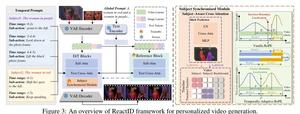
本文提出ReactID框架,旨在协调个性化视频生成中身份一致性与动作真实性的矛盾。针对主体-视频对齐不精确、训练不稳定、细粒度动作建模不足三大挑战,从数据、训练和动作建模三方面协同改进:构建高精度标注的ReactID-Data数据集;设计由易到难的渐进式训练课程;提出基于时间线的条件机制,通过主体感知交叉注意力和时间自适应RoPE,将子动作与特定主体绑定并嵌入时间坐标,从而生成更自然、可控的视频。
本文针对少样本动作识别中训练样本稀缺且视频结构复杂的问题,提出分层任务感知时间建模与匹配方法(HTTMM)。该方法通过分层结构充分建模时空特征,并利用任务感知机制增强对关键运动模式的感知,从而提升查询样本与支持样本之间的匹配效果。在多个基准数据集上的实验验证了其有效性,尤其适用于需要局部运动感知的细粒度动作分类任务。