视频理解
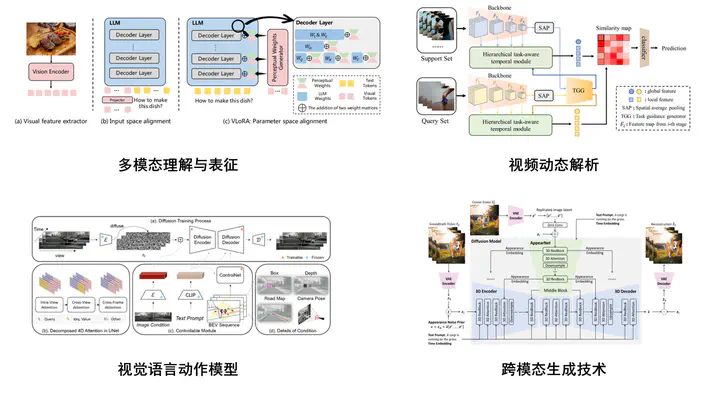
本方向聚焦于视频理解、生成与具身智能的核心技术突破。在多模态理解方面,构建融合视觉、文本与语音的统一语义框架,攻克跨模态检索、视觉问答及情感分析等难题。在视频动态解析上,利用时空建模技术实现高精度的行为识别与事件预测。同时,我们积极探索跨模态生成技术,结合扩散模型与自监督学习,推动内容可控且具真实感的图像视频创作。此外,团队正拓展视觉-语言-动作模型(VLA)研究,通过多模态指令理解与物理空间交互建模,赋予智能体连接虚拟认知与实体操作的能力,迈向具身智能的新高度。
本方向聚焦于视频理解、生成与具身智能的核心技术突破。在多模态理解方面,构建融合视觉、文本与语音的统一语义框架,攻克跨模态检索、视觉问答及情感分析等难题。在视频动态解析上,利用时空建模技术实现高精度的行为识别与事件预测。同时,我们积极探索跨模态生成技术,结合扩散模型与自监督学习,推动内容可控且具真实感的图像视频创作。此外,团队正拓展视觉-语言-动作模型(VLA)研究,通过多模态指令理解与物理空间交互建模,赋予智能体连接虚拟认知与实体操作的能力,迈向具身智能的新高度。